Day1
一、markdown
标题
ctrl +1、2、3、4、5、6是1-6级标题
代码块
三个反引号+编程语言是代码块
1 | #例如 python |
列表
无序列表:ctrl + shift + }
有序列表:ctrl + shift + {
文本加粗
ctrl + B
插入表格
段落插入
上传图片
! [] ()
PicGo
主题
设置、主题、获取主题、下载主题文件夹、放到主题文件夹
二、编程语言
1、什么是编程语言?
人与计算机之间沟通的媒介
2、什么是编程?
翻译的过程
3、为什么会出现编程语言?
三、计算机组成原理
1、什么是计算机?
通电的智能设备,批量执行命令
2、为什么要发明计算机?
干活
3、计算机的五大组成部分?
控制器、运算器、存储器、输入输出设备
4、计算机三大核心硬件
CPU、硬盘、内存
5、进制
6、计算机的操作系统
1、操作系统的由来
简化硬件操作,提供统一接口供应用程序使用
2、常见的操作系统
客户端Pc
Windows、MacOS、linux
移动端App
安卓、IOS、鸿蒙
3、软件
系统软件、应用软件
7、计算机系统的三层架构
硬件层、操作系统层、应用层
8、平台
硬件+操作系统
Windows 平台、MacOS平台、Linux 平台
跨平台:一个应用可以在多个平台上面使用
python跨平台!!
四、编程语言介绍
1、什么是编程语言
2、按照发展阶段
(1)机器语言
0、1二进制指令、直接操作底层硬件
机器语言:执行效率高、开发效率低;跨平台性差:不同的系统需要重新开发;学习成本高
(2)汇编语言
1 英文字母 + 特殊字符 表示某部分的机器指令
2 直接操作底层硬件:执行效率高
操作灵活:可以用英文字母代替机器指令
可执行文件小:编译后的文件小
开发效率低、跨平台性差、复杂度高
(3)高级语言
1 开发效率高、执行效率低
2 分类:
按照翻译方式不同:编译型语言:c、c++、c#、Java
解释型语言:python、go、php
3 什么是编译型语言?
将整篇源程序一次翻译成目标代码,然后生成可执行文件
修改源代码后,需要重新编译整个程序
执行效率高:执行文件之前先进行编译,执行编译后的文件
开发效率低:开发程序之后如果修改程序的源代码就需要重新编译然后才能运行
跨平台性差:先编译(根据操作系统进行文件的编译)
4 什么是解释型语言?
逐句翻译源程序中的代码,由解释器逐句执行
修改源代码后不需要重新编译整个程序,直接执行即可
执行效率低、开发效率高、具有较强的跨平台性
开发效率高:写的程序可以边编译边执行,如果其中一段代码报错然后修改,不需要等待所有的内容加载完后再去执行
跨平台型强:不需要经过编译
(4)总结
执行效率:机器语言 > 汇编语言 > 高级语言
开发效率:机器语言 < 汇编语言 < 高级语言
跨平台性:解释型语言的跨平台性最高
首选 python 的原因:极强的跨平台性、解释型语言可以边编译边执行
五、python
python的应用领域
数据分析:python里面有很多第三方模块
人工智能:同样有很多第三方包
爬虫:从网页上自动采集数据
云计算
web 开发全栈
图像处理:人脸识别:借助 python 的 opencv 模块进行图像处理和采集
python解释器的种类
CPython:基于c语言开发的
安装比新版本低两个版本的即可
Day2
pip.exe 是安装第三方包的时候的工具
疑惑?把它们区分开来即可。
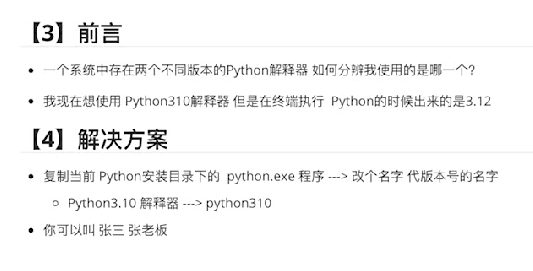
二、python代码的书写方式
1、在文本文件中书写
文本文件写代码 –> 改成 python 扩展名 –> 打开终端 –> 输入 python +路径(或者直接拖进来)
2、在终端执行
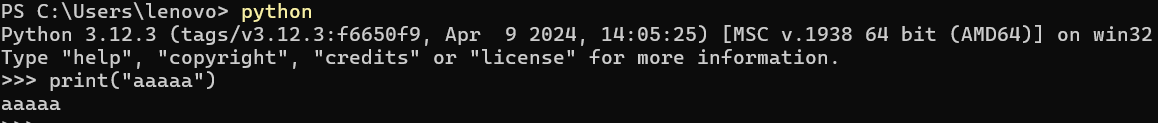
exit() 退出
3、pycharm编辑器
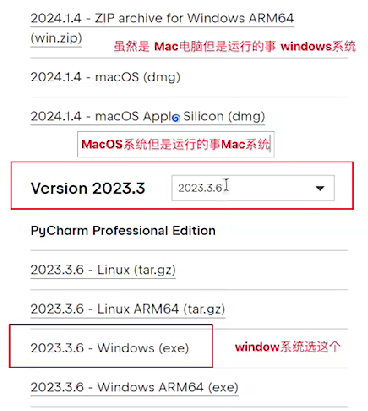
破解过程中遇到的问题:没有下载完整安装包
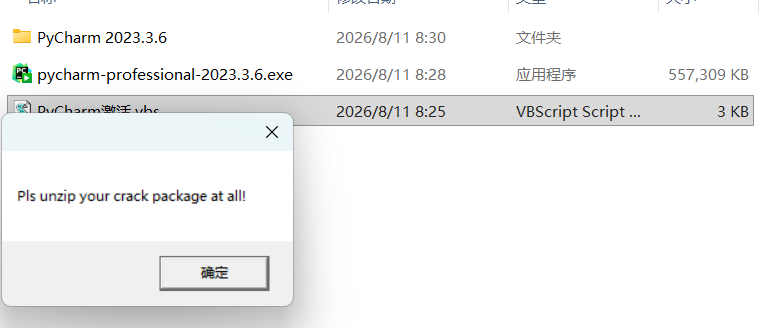
成功
三、补充
1、pip 换源
1 为什么要换源?
pip 安装第三方包的时候会非常慢,甚至可能无法完成
2 永久换源
永久的将 pip 源从国外的源切换到国内的源
1 | pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple/ |
1 | 清华大学: https://pypi.tuna.tsinghua.edu.cn/simple/ |
1 | 查看当前镜像源 |
3 临时换源
(3) 临时换源
- 可能当前源无法加载到指定的??模块??,于是可以临时切换到其他的源上面???
1 | pip install 模块名 -i https://pypi.tuna.tsinghua.edu.cn/simple/ |
2、系统环境和虚拟环境介绍
都是 python 解释器的环境
1 系统环境
系统环境是指安装在计算机全局范围内的Python环境。
当你在计算机上安装Python时,它会成为系统环境的一部分。
-在系统环境中安装的Python解释器和库对整个计算机可见,所有项目都可以访问它们。
2 虚拟环境
- 虚拟环境是一种在项目级别隔离Python依赖的方法。
- 通过创建虚拟环境,你可以为每个项目设置独立的Python环境,从而解决全局安装可能导致的问题。
- 虚拟环境可以包含自己的Python解释器和依赖库,与其他虚拟环境和系统环境隔离开。
3 开发项目
- 有一个项目使用的是Python 310版本的解释器但是使用的Django版本是3.12
- 有一个项目使用的是Python 310版本的解释器但是使用的Django版本是5.0
- 于是为了给每个项目产生于一个独立的隔离解释器环境就有了虚拟环境
3、创建虚拟环境的三种方式
1 venv
python自带的虚拟环境
使用:
- 打开命令行终端
- 导航到项目所在的目录
- 运行以下命令创建虚拟环境
- 例如:D:\Project\PythonProject\pythonInterpreter>python -m venv first
1 | python -m venv 虚拟环境名称 |
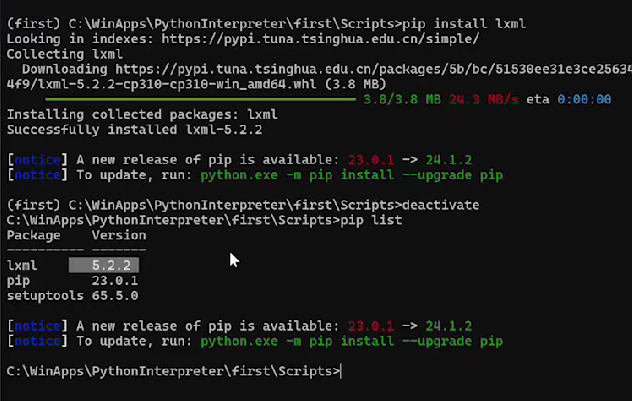
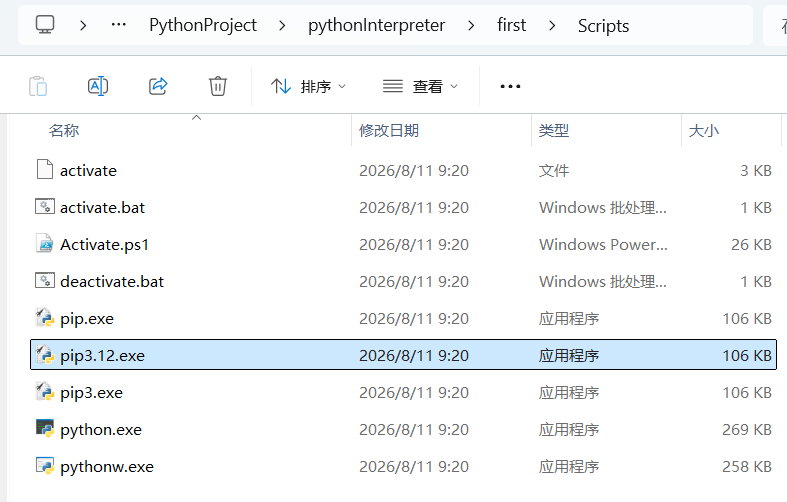
激活虚拟环境:
1 | 进入Scripts目录下 |
进入虚拟环境之后会在前面显示虚拟环境的名称:(first)

装入一个lxml
1 | pip install lxml |
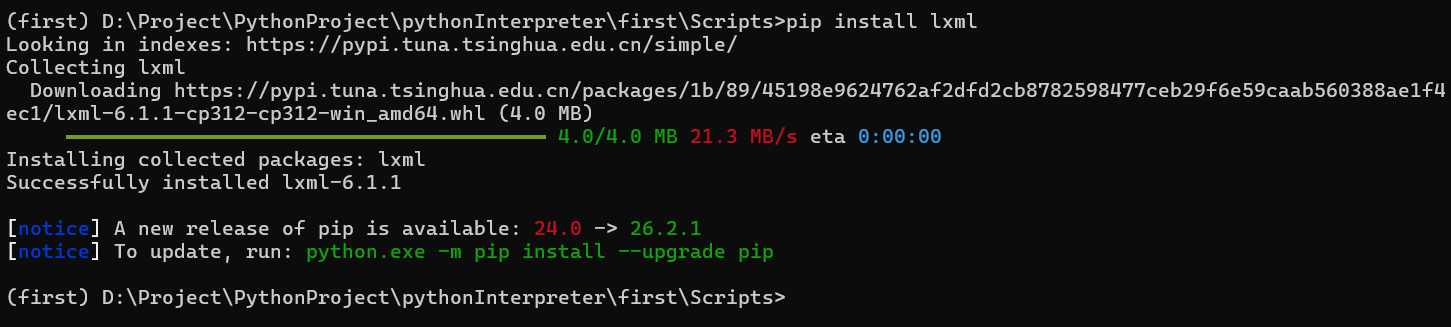
退出虚拟环境:
1 | deactivate |
pip list 查看
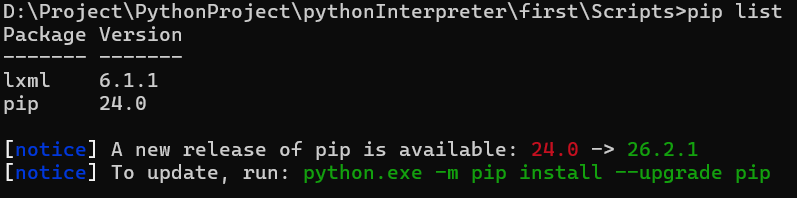
卸载:
1 | pip uninstall lxml |
pip list 看的是:已经安装的第三方软件包;dir() 看的是:某所有文件!!????
2 第三方的包:virtualenv
1 | pip install virtualenv |
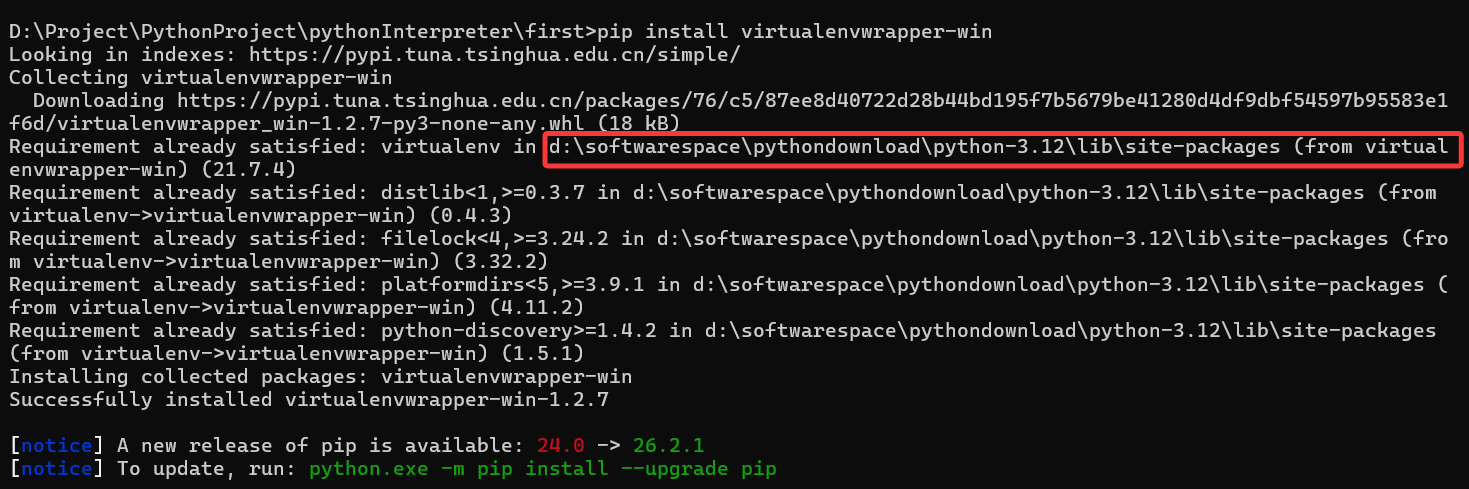
- 增加模块, 使虚拟环境在win上更好用
- virtualenvwrapper-win是一个增强模块, 使得在Windows上使用虚拟环境更方便。
- 使用以下命令安装virtualenvwrapper-win:
1 | pip install virtualenvwrapper-win |
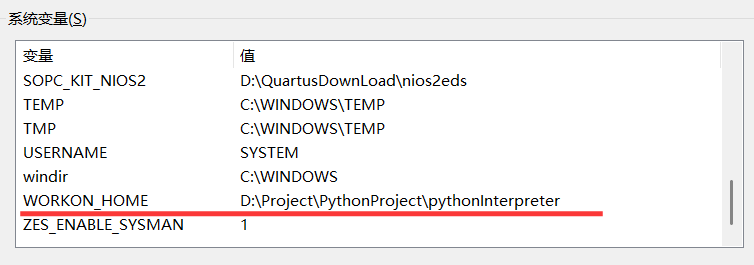
配置参数:打开系统环境变量添加一个变量名和变量值
变量名:WORKON_HOME
变量值:随便添加一个路径,随便哪个都行
找到Python3的安装目录, 然后进入Scripts文件夹, 双击运行virtualenvwrapper.bat文件。
例如:E:\Python310\Scripts
通过运行该脚本, 可以同步配置Virtualenv的使用环境和命令。
创建虚拟环境
1
2mkvirtualenv 虚拟环境名字
例如:mkvirtualenv second
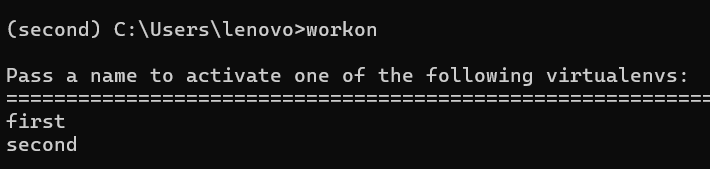
查看全局有哪些环境变量:
1 | workon |
4、pycharm补充
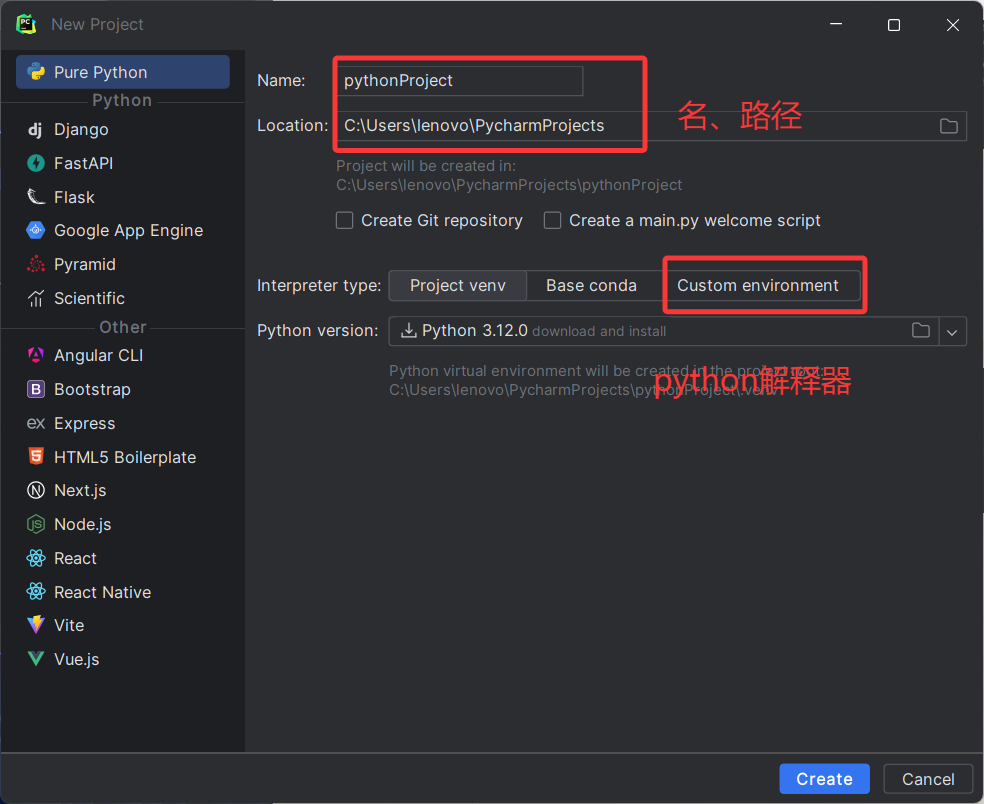
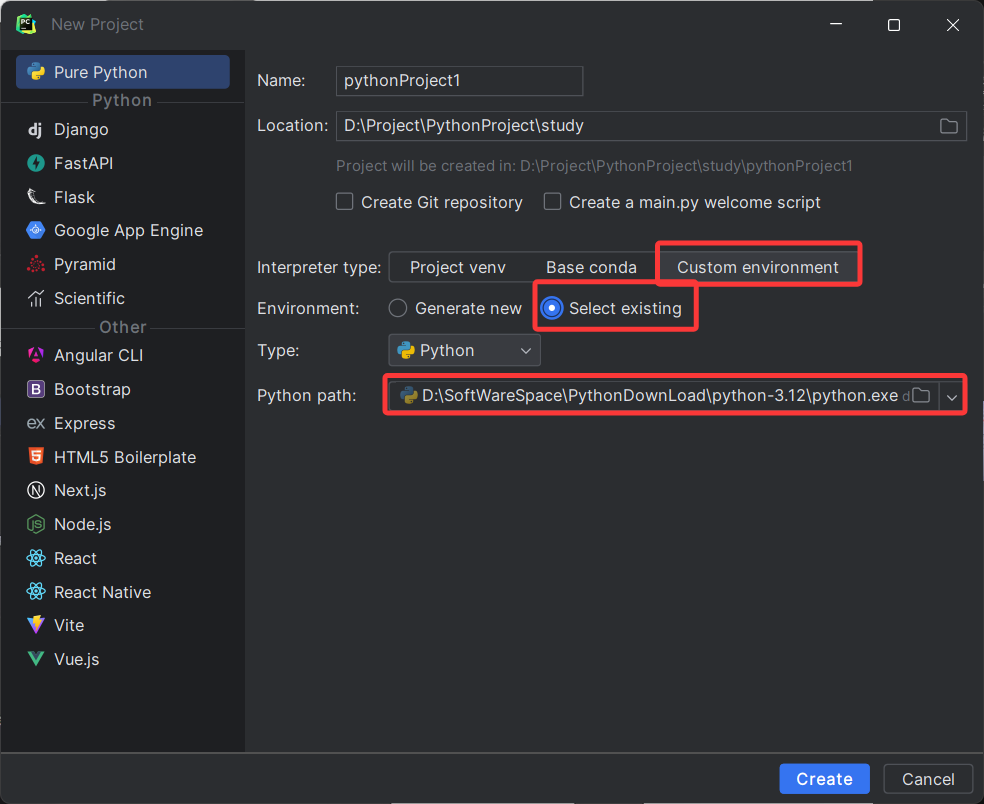
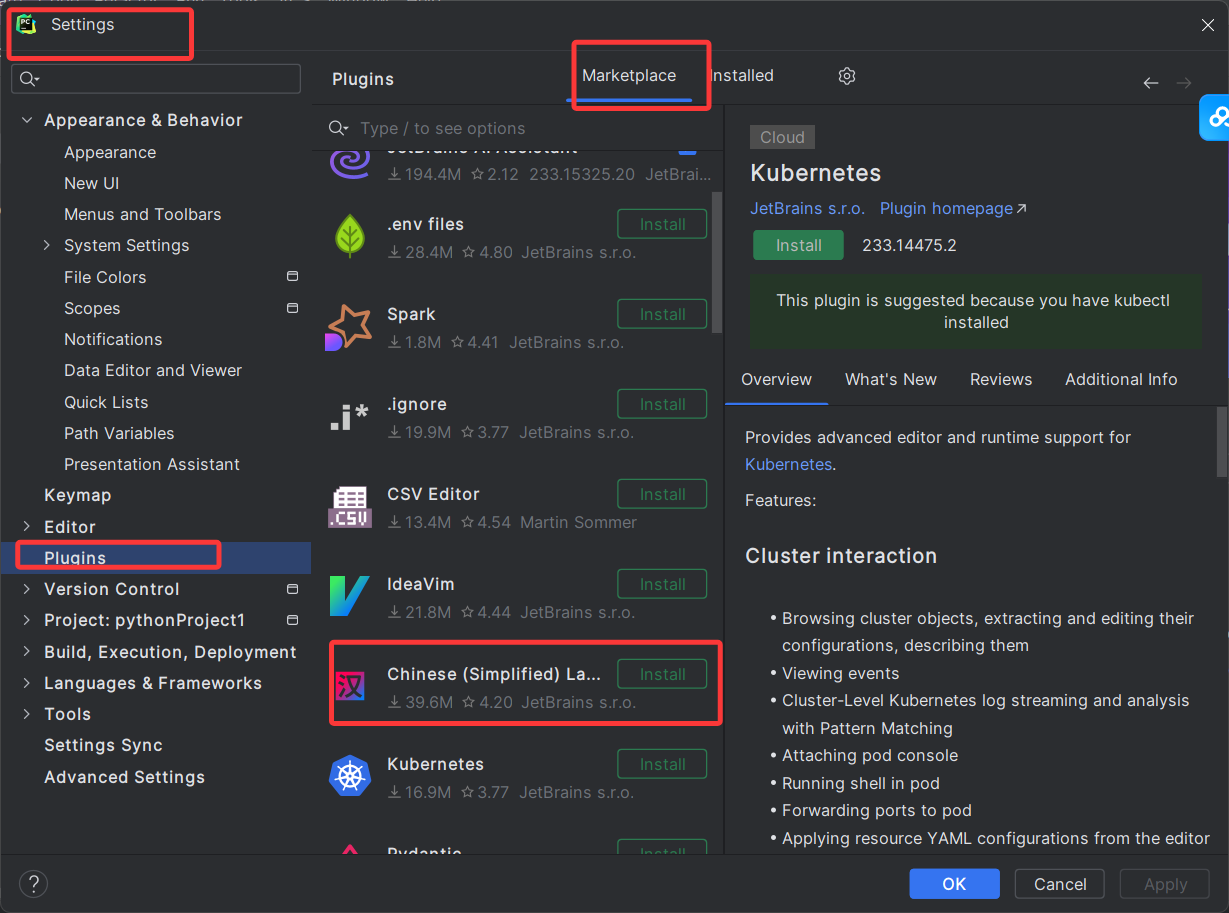
汉化:
快捷键:
- Ctrl + /: 行注释/取消行注释
- Ctrl + Alt + L: 代码格式化
- Tab / Shift +Tab: 缩进、不缩进当前行
- Ctrl+X/Shift+Delete: 剪切当前行或选定的代码块到剪贴板
- Ctrl+C/Ctrl+Insert: 复制当前行或选定的代码块到剪贴板
- Ctrl+V/Shift+Insert: 从剪贴板粘贴
- Ctrl + B / Ctrl + Click: 跳转到声明
- Ctrl左键:悬浮/单击鼠标左键, 显示简介/进入代码定义
- Ctrl + D: 复制选定的区域或行
python学习
1、变量的三大特性:
变量内存地址、变量类型、变量值
查看变量类型:type()
1 | print(type(userName)) |
查看变量内存地址:id()
重新运行地址会发生变化!
每一次在运行代码的时候都会重新开辟内存空间存储变量值
1 | print(id(userName)) |
2、常量
用全大写的字母代表常量
在 python 中的常量被定义后是可以改变的,但是我们都遵循不变的规则;在 Java、go 中定义常量后是不能修改的。
????那怎么判断呢????
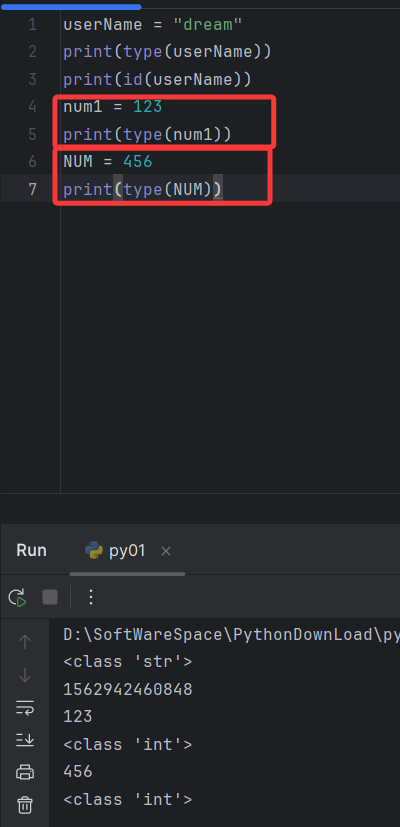
kimi给出的答案:了解即可
Python 没有内置的常量机制,只能通过命名约定和语言特性模拟来实现。
| 方式 | 强制程度 | 示例 |
|---|---|---|
| 全大写命名约定 | 无强制,靠自觉 | MAX_SIZE = 100 |
| typing.Final | 静态检查报错,运行时可改 | MAX_SIZE: Final = 100 |
| Enum | 运行时真正不可改 | class Color(Enum): RED = 1 |
| @dataclass(frozen=True) | 运行时不可改(抛 FrozenInstanceError) | 冻结数据类 |
3、PEP8规范
官方提供的命名规范
4、八大基本数据类型
整数(int)、浮点数(float)、字符串(str)、列表(list)、字典(dict)、布尔(bool)、元组(tuple)、集合(set)
1 字符串 str
- 单引号包裹起来的字符
- 双引号包裹起来的字符
- 三个单引号包裹起来的字符(可以多行)
- 三个双引号包裹起来的字符
嵌套的时候用不同的
1 | # 补充:字符串的使用方法 |
1 | # 数字进行加法----> 得到加法的结果 |
1 | # 正向索引取值 , 索引下表从 0 开始 |
百分号占位:
1 | sentence_one = "my name is dream ,my age is 18 " |
2 列表类型
1 | userNames = ["aa", "bb", "cc"] |
列表嵌套:
1 | data_info = ["aaa", "bbb", "ccc", [18, 19, 20, ["d", "e", "f"]]] |
Python 列表 vs 其他语言的数组:
kimi code的答案:
1 | # 1. 类型可以混装 |
3 字典类型
语法:{“key” : “value”}
1 | person_info = { |
4 列表和字典
解决的问题?
为什么python中有了列表类型,还要有字典类型呢,解决了什么问题?
- 列表用”位置”找数据,字典用”名字”找数据。 当数据有明确含义时,按下标找会很难用。
列表和字典的嵌套
遇到字典用键,遇到列表用下标,一层一层往里剥
1 | info = { |